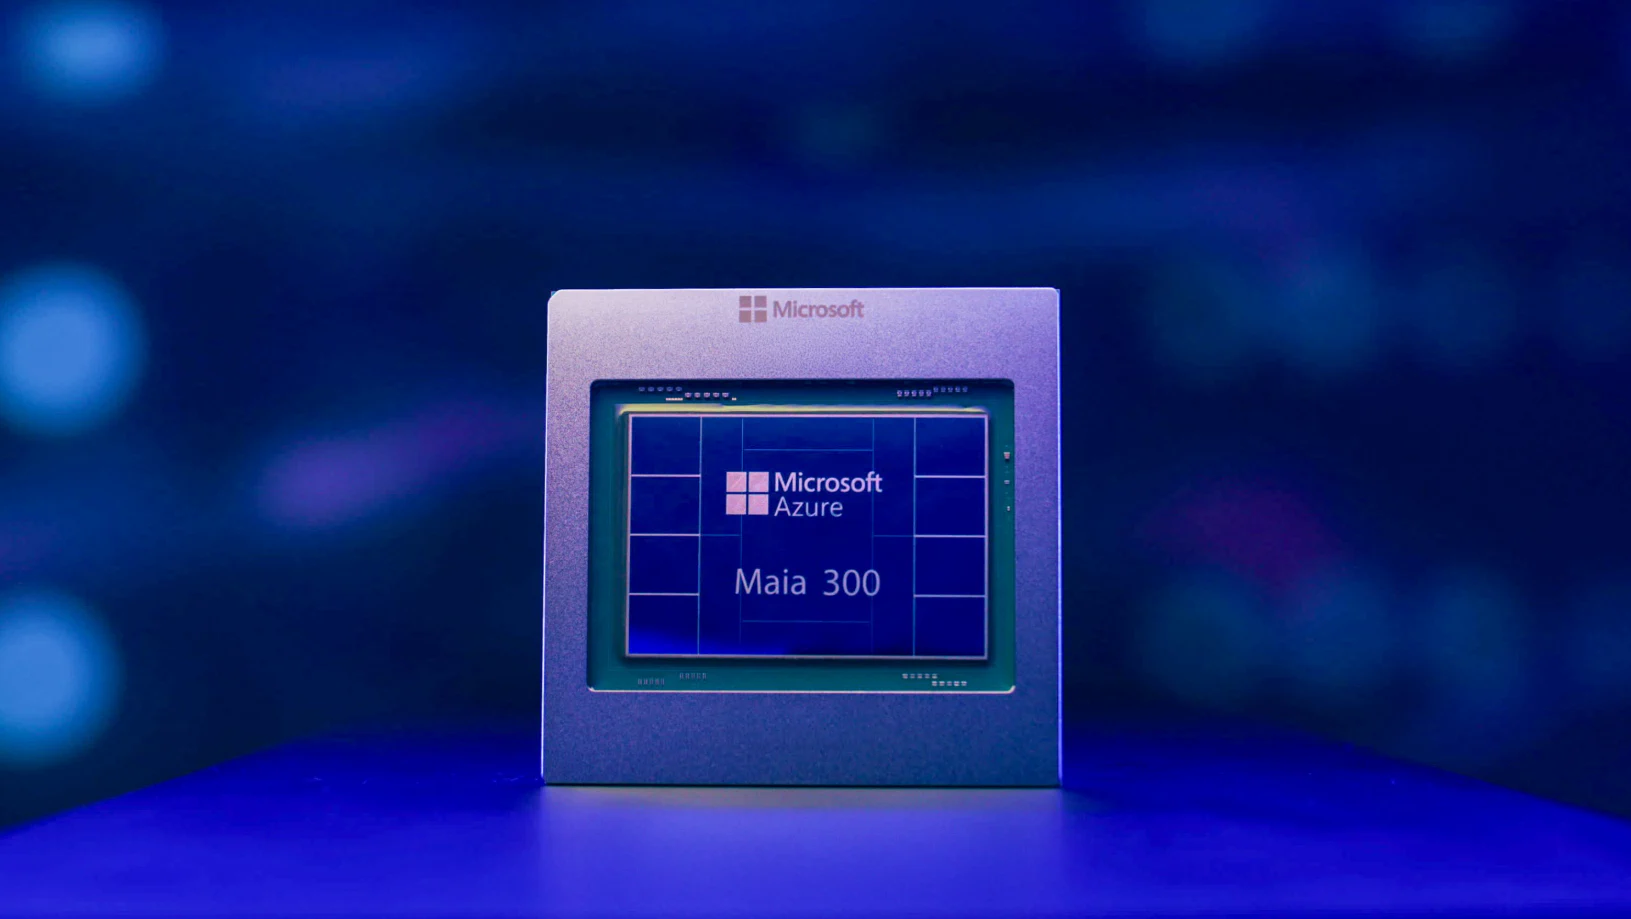
Microsoft prépare Maia 300, sa prochaine puce maison pour l’intelligence artificielle. Prévue pour 2027, elle doit devenir un élément central de l’infrastructure d’inférence d’Azure, de Copilot et des autres services du groupe. Forcément, la question arrive tout de suite : Microsoft veut-il se passer de Nvidia ?
La réponse courte est non, du moins pas complètement. Maia 300 est surtout une façon de reprendre le contrôle sur une partie très précise du coût de l’IA.
Maia 300 est pensée pour faire tourner les modèles
L’entraînement d’un grand modèle et son utilisation quotidienne ne posent pas exactement les mêmes problèmes. L’entraînement demande une puissance massive pour ajuster les paramètres. L’inférence consiste ensuite à produire des réponses, token après token, pour des millions d’utilisateurs.
Maia 300 est une puce « inference-first ». Microsoft l’optimise pour les longues fenêtres de contexte, les modèles de raisonnement et les phases de génération où le décodage devient le principal goulot d’étranglement. Ce n’est donc pas une carte graphique pour PC, et elle ne sera pas vendue aux joueurs.
La puce s’appuie sur huit piles de mémoire HBM4 et annonce jusqu’à 18 To/s de bande passante mémoire, pour une enveloppe thermique de 950 W. Microsoft prévoit des racks de 96 accélérateurs, reliés pour fonctionner comme un seul grand système.
Les chiffres de Microsoft sont impressionnants, mais internes
Microsoft affirme que Maia 300 produira 40 % de tokens supplémentaires par mégawatt par rapport aux principaux systèmes à base de GPU. Le groupe annonce aussi jusqu’à sept fois le débit de tokens d’un rack Maia 200 dans une configuration complète de 96 accélérateurs.
Ces nombres sont importants, parce que l’électricité et le refroidissement représentent une part énorme du coût des centres de données. Si Microsoft obtient vraiment plus de réponses utiles avec la même puissance, il peut réduire le prix de chaque requête et mieux rentabiliser ses infrastructures.
Il faut toutefois garder une réserve claire : il s’agit de comparaisons fournies par Microsoft, sur ses propres charges de travail et avec sa propre définition du « token utile ». Les performances indépendantes ne seront réellement mesurables qu’une fois les systèmes déployés en 2027.
Pourquoi Nvidia reste difficile à remplacer
Nvidia ne vend pas seulement des puces rapides. L’entreprise fournit CUDA, des bibliothèques, des outils de développement, des interconnexions et tout un écosystème que les chercheurs et les entreprises utilisent depuis des années.
Maia 300 n’a pas besoin de battre Nvidia sur chaque tâche pour être intéressante. Microsoft contrôle Azure, ses centres de données et une grande partie des logiciels servis dessus. Il peut donc concevoir une puce autour de ses besoins réels, puis adapter les modèles et les outils à cette architecture.
C’est un avantage énorme pour Copilot et les services internes. Par contre, un client qui veut entraîner un modèle très différent, migrer facilement entre plusieurs clouds ou utiliser un logiciel prévu pour CUDA peut toujours préférer les GPU Nvidia.
Lisuan LX 7G100 : la Chine va bousculer Nvidia et AMD ?
Le vrai objectif : réduire la dépendance et le coût
Avec Maia 300, Microsoft cherche surtout à diversifier son approvisionnement. Le groupe peut réserver ses GPU les plus polyvalents aux charges qui en ont besoin, puis basculer une partie de l’inférence répétitive vers son propre silicium.
Cette stratégie ressemble à celle d’autres géants du cloud. Une puce maison n’élimine pas le fournisseur dominant du jour au lendemain. Elle donne un levier de négociation, limite les pénuries et permet d’optimiser chaque watt jusque dans les logiciels.
Au final, Maia 300 ne signe pas la fin de Nvidia chez Microsoft. Elle peut en revanche réduire le nombre de GPU nécessaires pour certains services et mettre une pression nouvelle sur le rapport performance-prix. La bataille ne se jouera donc pas sur une fiche technique isolée, mais sur le coût réel d’un token produit à l’échelle de plusieurs gigawatts.